제노바에서 발표한 Xronos: MASCOTS 2026 참가기
Conference: MASCOTS 2026 (The 34th IEEE International Symposium on the Modeling, Analysis, and Simulation of Computer and Telecommunication Systems) - Genova, Italy
Author: 박선재 (Sunjae Park) | Date: 2026
학회 개요 및 주요 트렌드
IEEE MASCOTS(International Symposium on Modeling, Analysis, and Simulation of Computer and Telecommunication Systems)는 컴퓨터 시스템과 네트워크의 성능을 측정하고 모델링·분석하는 연구를 다루는 국제 학회로, BK21 우수국제학술대회 IF2에 해당한다. 올해로 34회째를 맞았고, 이번에는 이탈리아 제노바 대학교에서 3일간 열렸다. 논문 발표를 위해 참가하게 되었다. 학회 이름만 보면 전통적인 성능 모델링이나 시뮬레이션 연구가 중심일 것 같았지만, 실제 프로그램을 보니 LLM 관련 세션만 두 개였고, AI 시스템 성능과 엣지 환경을 다루는 세션도 따로 있었다. LLM 추론과 학습, KV cache 관리, 엣지 컴퓨팅처럼 요즘 시스템 분야에서 많이 다루는 주제들을 성능 분석의 관점에서 접할 수 있었다. 또 규모가 크지 않아 모든 세션이 겹치지 않고 single track으로 진행되었는데, 덕분에 관심 분야가 아닌 발표도 자연스럽게 듣고 관심을 가질 수 있었다.
논문 발표 및 현장 학술 교류
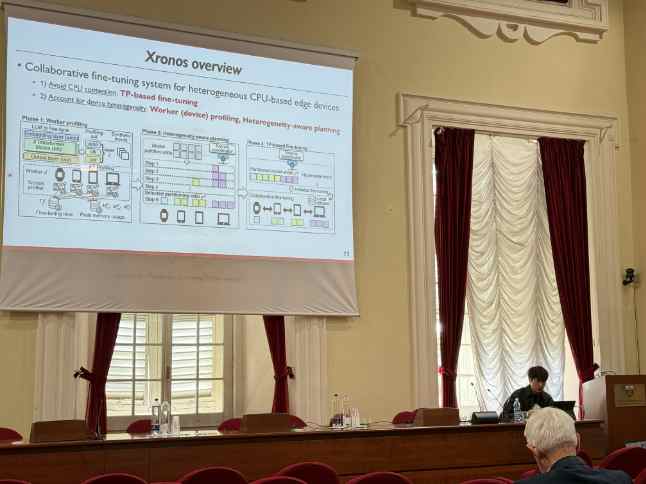
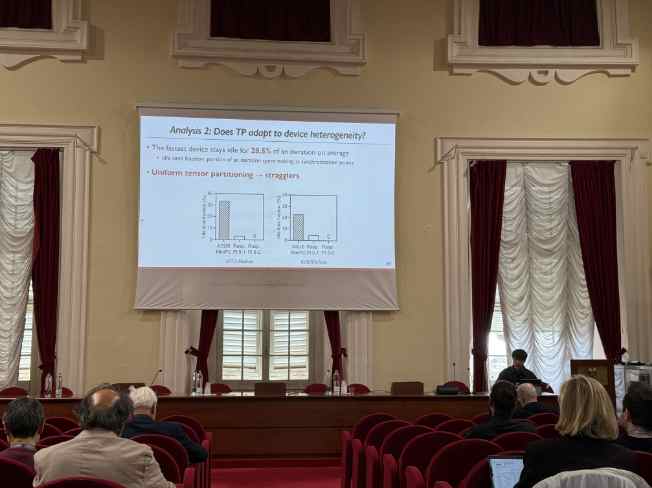
발표는 둘째 날 'Performance Evaluation for Large Language Models II' 세션에서 진행했다. 발표한 논문은 "Xronos: Heterogeneity-Aware Tensor Parallelism for Collaborative LLM Fine-Tuning on Edge CPUs"로, CPU만 있는 여러 엣지 장치가 함께 LLM을 fine-tuning할 때 생기는 문제를 분석하고 이를 해결하는 시스템을 제안한 연구이다. 질의응답을 포함해 약 25분이 주어졌다. 이번 학회는 첫 국제학회였고, 해외 경험이 거의 처음이었다. 그래서 영어로 20분 넘게 발표하고 질문에 답해야 한다는 것이 가장 큰 부담이었다. 발표를 준비하면서 가장 많이 고민한 부분은 처음 듣는 사람도 흐름을 따라올 수 있도록 이야기를 구성하는 것이었다. 'CPU 장치에서도 파이프라인 병렬화가 효과적인가?', '기존 텐서 병렬화를 그대로 쓰면 되는가?'라는 두 질문을 먼저 던지고, 분석으로 하나씩 답한 뒤 그 답에서 Xronos의 설계가 나오도록 슬라이드를 짰다. 수식과 기호는 최대한 말로 풀었고, 발표 연습을 하면서 발음이 자꾸 꼬이는 단어는 쉬운 단어로 바꿨다. 심사위원 코멘트를 바탕으로 예상 질문과 답변도 미리 정리해 갔다. 그렇게 준비했는데도 막상 발표장에서는 많이 긴장해서, 질의응답 시간에 받은 질문에 충분히 답하지 못한 것 같아 아쉬웠다. 실험에 사용한 장치 설정에 대한 질문과, 이 구조를 SFL(Split Federated Learning)로 확장할 수 있는지에 대한 질문을 받았다. 세션이 끝난 뒤 질문하신 분들을 따로 찾아가 다시 이야기를 나눴는데, 짧은 질의응답 시간에는 다 말하지 못했던 설계 의도와 실험 결과를 차분히 설명할 수 있었다. 오히려 이 대화에서 연구의 한계와 확장 방향에 대해 더 많은 의견을 들을 수 있었다.
주목할 만한 연구 동향
Exploring Memory Partitioning of LLMs for Faster Inference on CPUs
학회에서 인상 깊게 본 연구 중 하나는 둘째 날 LLM 세션에서 발표된 Exploring Memory Partitioning of LLMs for Faster Inference on CPUs였다. LLM 추론은 모델 파라미터를 메모리에서 얼마나 빨리 읽어 오느냐에 성능이 크게 좌우되는데, CPU가 쓰는 DDR 메모리는 GPU의 HBM보다 대역폭이 낮아 그동안 CPU에서의 LLM 추론은 불리하다고 여겨져 왔다. 최근에는 HBM과 DDR을 함께 갖춘 CPU가 등장하면서 이 격차가 줄고 있는데, 이 연구는 이런 이종 메모리 구조에서 모델의 어떤 부분을 어느 메모리에 둘지를 다룬다. 층(layer) 단위 또는 attention, FFN 같은 텐서 단위로 모델을 나누고, 대역폭에 민감한 부분을 HBM에 배치하는 방식이다. 논문에 따르면 x86과 AArch64 환경에서 DDR만 쓰는 경우보다 최대 1.87배 빠른 추론 성능을 보였다. 이 연구가 특히 눈에 들어온 이유는 문제를 바라보는 방식이 Xronos와 닮아 있었기 때문이다. Xronos는 성능과 메모리가 서로 다른 여러 장치에 모델을 나누어 배치하고, 이 연구는 한 시스템 안에서 대역폭과 용량이 서로 다른 메모리에 모델을 나누어 배치한다. 대상은 다르지만, 이종성을 고려해 모델을 어떻게 쪼개고 어디에 둘지가 성능을 좌우한다는 점은 같았다. 또 저자들이 배치를 자동으로 결정하는 정책과 이를 위한 비용 모델을 향후 과제로 꼽았는데, Xronos가 profiling 기반 비용 모델로 분할을 자동으로 결정한다는 점과 비교해 보며 들을 수 있어 흥미로웠다.
참석 소감 및 현장 이야기
이번 MASCOTS는 처음으로 내 연구를 해외 연구자들 앞에서 직접 발표했다는 점에서 의미가 컸다. 논문을 쓸 때는 기술적으로 정확하게 쓰는 데 집중했다면, 발표를 준비하면서는 같은 내용을 처음 듣는 사람에게 어떻게 이해시킬지를 계속 고민하게 되었다. 좋은 연구만큼이나 그 연구를 명확하게 전달하는 것도 중요하다는 것을 직접 느꼈다. 가장 기억에 남는 것은 학회 기간의 식사 자리였다. 한국에서 온 연구자들은 물론 여러 나라의 연구자들과 한 테이블에 앉아 일상 이야기부터 각자의 연구 이야기까지 자유롭게 나눴다. 발표장에서는 듣기 어려운 연구 과정에서의 고민이나 경험을 들을 수 있었고, 자연스럽게 네트워킹으로 이어졌다. 같은 고민을 하는 연구자들이 세계 곳곳에 있다는 것을 직접 확인하면서 앞으로 연구를 이어 갈 동기부여를 크게 받았다. 또한 대한민국이 아닌 타지에서의 생활을 하며 이탈리아의 문화를 접하고 여러 사람들과 대화를 해본 경험이 정말 소중하였고, 인터넷에서 사진으로 보기만 한 여러 문화재를 직접 볼 수 있어서 값진 경험이었다. 학회에서 받은 질문과 대화가 다음 연구의 방향을 잡는 데에도 실제로 도움이 되었으며, 처음이라 부담도 컸지만, 그만큼 배운 것이 많은 출장이었다.