[DAC 2026] 분산 딥러닝 선점 가속 연구 발표와 Best Paper Candidate 선정 후기
Conference: DAC 2026 (The 63rd ACM/IEEE Design Automation Conference) - Long Beach, CA
Author: 고영훈 (Younghun Go) | Date: 2026.07.29
학회 개요 및 주요 트렌드
Design Automation Conference (DAC)는 반도체 설계 자동화, 컴퓨터 아키텍처 및 시스템 분야를 다루는 대표적인 국제 학회로, BK21 우수국제학술대회 IF3에 해당한다. 이번 DAC’26에는 논문 발표를 위해 참가하게 되었다. 기존 DAC는 칩 설계와 반도체 분야를 중심으로 연구가 발표되는 학회라는 인상이 강했다고 하지만, 최근에는 AI 및 시스템 분야까지 연구 범위가 점차 확장되고 있다. 실제 학회에서도 AI 시스템, GPU 및 가속기, 대규모 모델 학습 및 추론 시스템 등 다양한 주제의 연구를 접할 수 있었다. 평소 연구실에서 주로 접하던 시스템 학회와는 조금 다른 관점에서 AI 시스템을 바라볼 수 있다는 점도 흥미로웠다.
논문 발표 및 현장 학술 교류
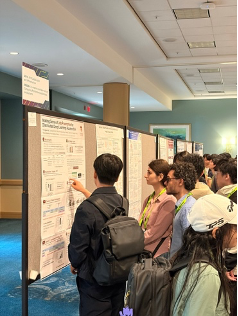
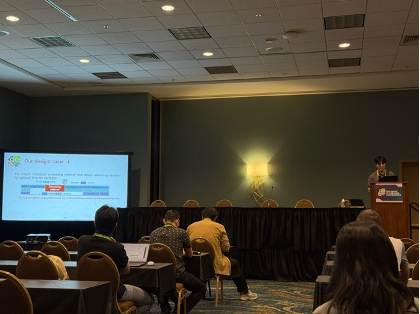
DAC에서는 약 12분간의 oral presentation을 진행한 뒤, 세션이 끝나면 이어서 포스터 발표를 진행한다. Oral session에서 별도의 Q&A를 진행하지 않는 대신, 발표 이후 포스터 세션에서 청중과 직접 이야기를 나누는 방식이다. 따라서 oral 발표와 포스터를 모두 준비해야 한다는 점에서 준비 과정의 부담이 적지 않았다. 특히 영어가 모국어가 아닌 입장에서 영어로 연구 내용을 발표하는 것은 여전히 부담이 되는 일이다. DAC는 학회 개최 약 두 달 전부터 발표 자료를 미리 준비하고 session chair의 피드백을 받아 수정하는 절차가 있어 자연스럽게 발표를 일찍부터 준비하게 되었다. 감사하게도 이번 논문이 Best Paper Candidate로 선정되어, 일반 발표 준비와 별도로 심사를 위한 약 15분 분량의 발표 영상을 녹화하는 과정도 거쳤다. 이번 발표를 준비하면서 특히 많이 배운 부분은 연구 내용을 ‘내가 설명하기 편한 순서’가 아니라 ‘청중이 이해하기 쉬운 순서’로 구성하는 것의 중요성이었다. 교수님들과 여러 차례 발표 자료를 수정하면서 장표의 순서, 그림의 구성, 문장의 표현 하나까지도 청중의 관점에서 다시 생각해보게 되었다. 연구 내용을 정확하게 전달하는 것뿐만 아니라, 처음 접하는 사람도 자연스럽게 문제와 핵심 아이디어를 따라올 수 있도록 이야기를 구성하는 것이 중요하다는 점을 다시 느꼈다. 발표 이후 포스터 세션에서는 oral presentation에서 충분히 설명하지 못했던 부분을 조금 더 구체적으로 설명하고, 연구에 관심을 보인 참가자들과 직접 이야기를 나눌 수 있었다. 짧은 구두 발표와 달리 상대방의 질문에 따라 연구의 세부적인 내용을 설명할 수 있다는 점에서 포스터 발표만의 장점도 느낄 수 있었다. 한편 아쉬웠던 점도 있다. 첫 국제학회 발표는 아니었지만, Best Paper 심사와 oral 및 poster 발표를 모두 준비해야 한다는 부담이 생각보다 컸다. 학회에 있는 동안에도 발표를 계속 신경 쓰다 보니 다른 연구자들의 발표를 충분히 듣거나 학회 자체를 여유롭게 즐기지는 못했던 것 같다. 다음 학회에서는 발표 준비를 조금 더 일찍 마무리하고, 현장에서 다른 연구를 접하는 데 더 많은 시간을 쓰고 싶다.
주목할 만한 연구 동향
eLLM: Elastic Memory Management Framework for Efficient LLM Serving
학회에서 인상 깊게 본 연구 중 하나는 eLLM: Elastic Memory Management Framework for Efficient LLM Serving이었다. eLLM은 LLM 추론 과정에서 GPU 메모리를 보다 효율적으로 활용하기 위한 연구이다. 기존 LLM serving system에서는 activation과 KV cache가 서로 다른 방식으로 관리되기 때문에, 한쪽에 여유 메모리가 있더라도 다른 쪽에서 이를 유연하게 활용하기 어렵다는 문제가 있다. eLLM은 이를 해결하기 위해 activation과 KV cache가 사용할 수 있는 GPU 메모리를 통합하여 관리하고, 실행 중 필요한 메모리 크기에 따라 두 영역의 크기를 동적으로 조절한다. 특히 흥미로웠던 부분은 운영체제의 memory ballooning에서 아이디어를 가져와 GPU 메모리를 elastic하게 관리한다는 점이었다. GPU 내부에서 메모리 할당을 동적으로 조절하는 것뿐만 아니라, GPU 메모리가 부족할 경우 CPU 메모리까지 활용하며 SLO를 고려해 데이터 이동 여부를 결정한다. 이를 통해 기존 시스템보다 GPU 메모리를 효율적으로 활용하고, 실험에서는 최대 2.32배 높은 decoding throughput과 128K-token 입력에서 최대 3배 큰 batch size를 지원했다고 한다. 현재 나도 LLM serving 과정에서 GPU KV cache 용량의 제약과 CPU-GPU 간 KV cache 이동으로 발생하는 성능 저하를 다루는 연구를 진행하고 있어 특히 관심 있게 보았다. 우리가 주로 KV cache의 이동과 그로 인해 발생하는 실행 지연을 어떻게 줄일 것인지에 초점을 맞추고 있다면, eLLM은 한 단계 아래에서 GPU 메모리 자체를 어떻게 구성하고 유연하게 배분할 것인지를 다룬다는 점에서 차이가 있었다. 비슷한 문제를 서로 다른 관점에서 해결하는 연구를 학회 현장에서 직접 접할 수 있었다는 점이 인상 깊었다.
참석 소감 및 현장 이야기
이번 DAC는 논문을 직접 발표한다는 점에서도 의미가 있었지만, 연구를 어떻게 전달해야 하는지 다시 생각해볼 수 있었다는 점에서 개인적으로 좋은 경험이었다. 논문을 작성할 때는 정확성과 기술적인 내용에 집중하게 되지만, 학회 발표에서는 제한된 시간 안에 연구의 문제와 핵심 아이디어를 처음 보는 사람에게 이해시키는 것이 무엇보다 중요했다. 발표 준비 과정 자체가 내가 진행한 연구를 다시 정리하고, 무엇이 이 연구의 핵심 contribution인지 되돌아보는 계기가 되었다. 학회가 열린 Long Beach는 바다와 항구가 가까운 도시였고, 학회장 주변을 걸어서 이동할 수 있어 일정 중간이나 발표가 끝난 뒤 잠시 둘러보기 좋았다. 특히 발표를 마친 이후에는 준비 과정에서 느꼈던 긴장이 풀리면서 주변을 조금 더 여유롭게 둘러볼 수 있었다.